
01 / Overview · 当深度提示本身出错
深度补全通常把传感器读数当作可靠的几何锚点。但镜面与透明物体会改变这个前提:镜中虚像、透射背景与混合回波,都可能形成连续、看似合理的错误深度。模型即使补出了完整的深度图,也可能只是把这些错误保留下来。
TrustPrompt 研究模型何时会继承错误提示,以及什么信息能够阻止这种继承。项目的贡献包括错误继承的度量、一组有预注册判读规则的探索,以及对先验一致性干预效果与边界的评估。
GitHub 仓库 ↗ · 完整分析报告 ↗ · 正式测试与统计检验 ↗
观察:适配得更充分,也可能错得更一致
在 NYU 开发集上,六个前馈模型都会不同程度地继承镜面读数;CAPA 则在适配过程中进一步靠近错误提示。干净区域可以同时变好,因此整图平均误差不足以解释这种行为。
| 开发集观察 | 结果 | 含义 |
|---|---|---|
| 六个前馈模型 · NYU val | 污染区继承率 IR:0.17–0.93 | 错误继承跨模型存在,程度不同。 |
| CAPA · NYU 开发集 | IR:0.068 → 0.953 | 适配前与 100 步后对比,错误提示被逐步采纳。 |
| 同一 CAPA 对比 | 污染区 AbsRel:0.139 → 0.919 | 误差约扩大 6.6 倍,即使干净区有所改善。 |
上述现象来自开发集,不属于后文的正式 test 主比较。CAPA 使用 UniDepthV2-L + LoRA;第 0 步是经读数对齐的适配前先验。六模型结果 · CAPA 继承预检
提示与图像在局部看起来一致,仍可能共同描述了错误的表面。需要检验的是这种“一致”是否值得信任。
- 分析问题:哪些线索能区分错误提示?六条探索没有在两个数据集上同时通过预设门槛。
- 干预结果:T v1 在 6 个补全模型 × 2 个数据集的 12 项正式比较中,有 10 项显著降低污染区误差。
- 研究状态:方法 v1 已冻结,正式 test 已完成。本页于 2026-11-13 修订展示,实验结果沿用截至 2026-11-04 的研究记录。
02 / Method · 从区分信号到可信度干预
为什么常见线索没有解决问题
如果错误在局部几何上足够连贯,置信度、拟合速度或“读数偏远”本身就未必能识别它。项目在开发集上检验了六条路线,每条先写定判读规则;这些结果帮助解释干预的作用与边界,而非证明所有局部线索都无效。
| 开发集探索 | 未通过的关键条件 |
|---|---|
| 将检测内化到 OMNI-DC | 检测能力提升,但干净区代价未通过门槛。 |
| 把测远读数作为单侧上界 | Marigold-DC 引导未达到预设改善门槛。 |
| 把错误解释为第二层表面 | HAMMER 第二层占比为 0.439,CI 下限未达到 0.50。 |
| 用适配残差变化检测错误 | 错误可在早期被拟合,两个数据集未同时出现要求的区分能力增益。 |
| 使用先验自身的不确定度 | 逐像素区分能力接近随机,没有形成有效信赖域。 |
| 对 PromptDA-L 做激活修补 | NYU 的描述性定位集中于细尺度融合分支,HAMMER 未出现规定的总效应。 |
相较之下,读数与全局先验的不一致保留了区分能力:独立的开发集预检使用 UniDepthV2-L,其残差在 NYU 和 HAMMER 全图上的 AUROC 分别为 0.952、0.743。这一观察支持引入全局几何参照;具体 T v1 实现采用较小的 UniDepthV2-S,二者的模型与实验角色应区分。探索细节与判读见报告第 4–6 节。
T v1:先检查,再交给下游模型
方法以传感器读数和冻结单目先验之间的不一致为主要依据。先验提供场景的全局几何参照,可信度检测器再决定哪些读数应被保留。T v1 结合 RGB、提示、先验及残差等输入,不使用编码器特征;阈值在开发阶段标定,正式测试前冻结。
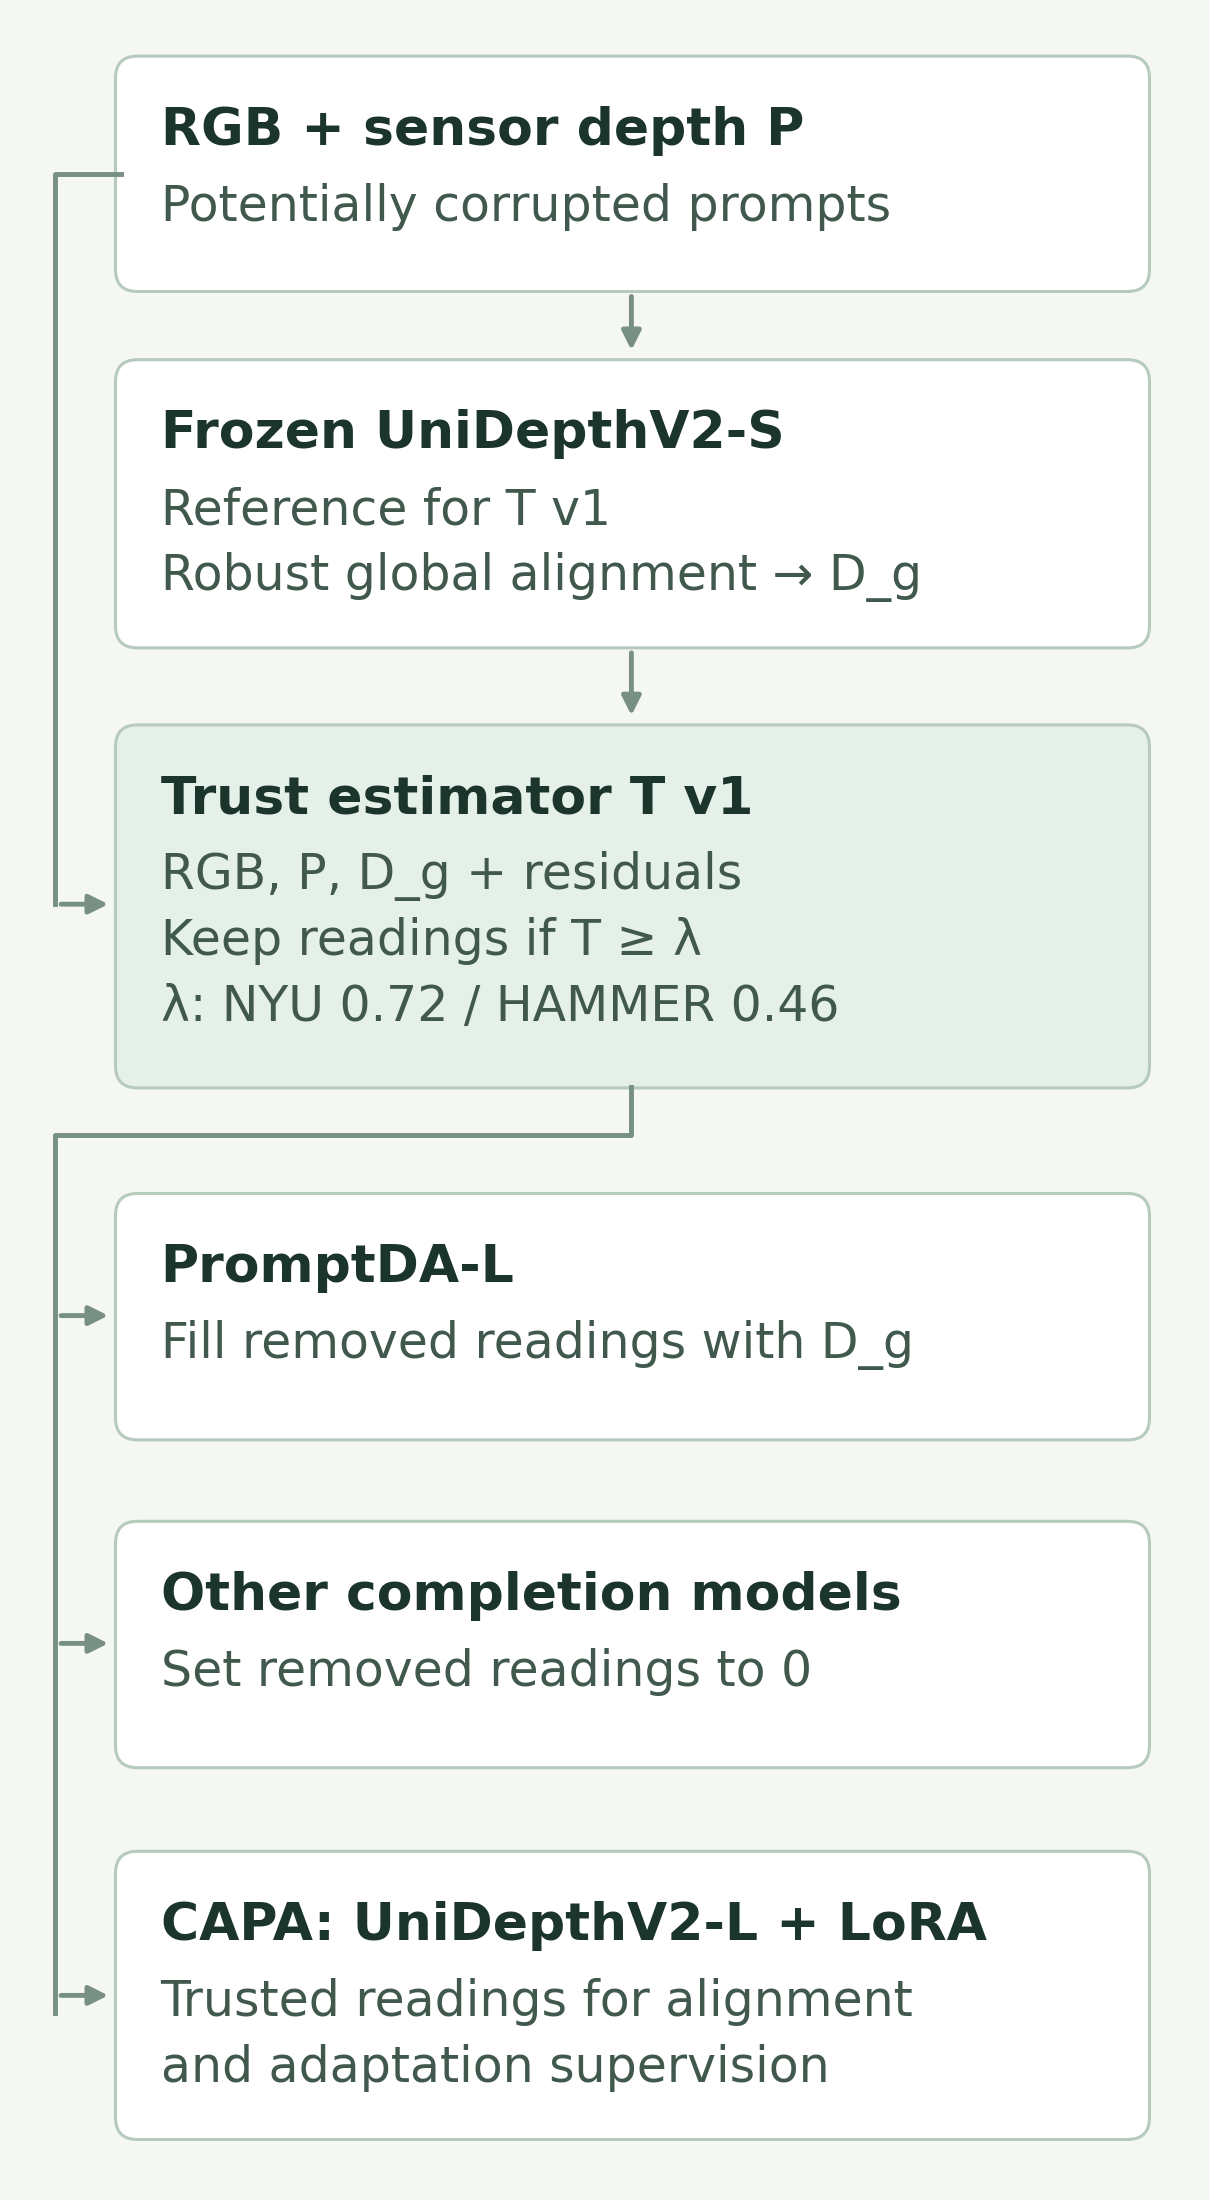
- 建立参照:冻结的 UniDepthV2-S 生成单目深度,与传感器读数在逆深度空间做全局鲁棒尺度与平移拟合,得到对齐先验 Dg;推理时不使用 GT。
- 判断可信度:T v1 预测读数可信度,屏蔽 T < λ 的位置;NYU 的 λ = 0.72,HAMMER 的 λ = 0.46。
- 处理提示:PromptDA-L 在被屏蔽处填入 Dg;其余五个补全基线将这些读数置零,再由模型补全。
- 接入自适应:CAPA 扩展实验使用 UniDepthV2-L + LoRA。掩码同时限制读数对齐的支持点和适配损失中的监督读数,其余配置保持一致。
阈值采用 conformal 风险控制进行标定,但其保证依赖标定与测试数据的可交换性。它不是任意新场景下的可靠性承诺;HAMMER 的正式测试正好暴露了这一边界。
评测什么,避免掩盖什么
主指标是污染区 C 的平均绝对相对误差(AbsRel,越低越好)。污染区满足 |P − GT| / GT > 0.05;NYU 在镜面内评测,HAMMER 在物体区域内评测。深度按米制 Z 计算,主评测不对 GT 做尺度或仿射对齐。
继承率 IR 衡量模型是否仍贴近错误提示:在 C 内,预测与提示相差小于 5%,但与 GT 相差大于 5% 的像素占比。干净区误差与无效预测同时报告;不能通过删掉难例来改善主结果。
03 / Experiments · 收益与代价一起报告
正式 test:12 项比较,10 项显著改善
方法 v1 于 2026-11-02 冻结。正式测试使用 NYU Mirror3D 的 30 张图、23 个场景,以及 HAMMER 场景 12–14 的 858 个样本(三种传感器)。模型、阈值、评测代码与比较族在读取 test 前锁定,共 37 个文件以 SHA256 核对。
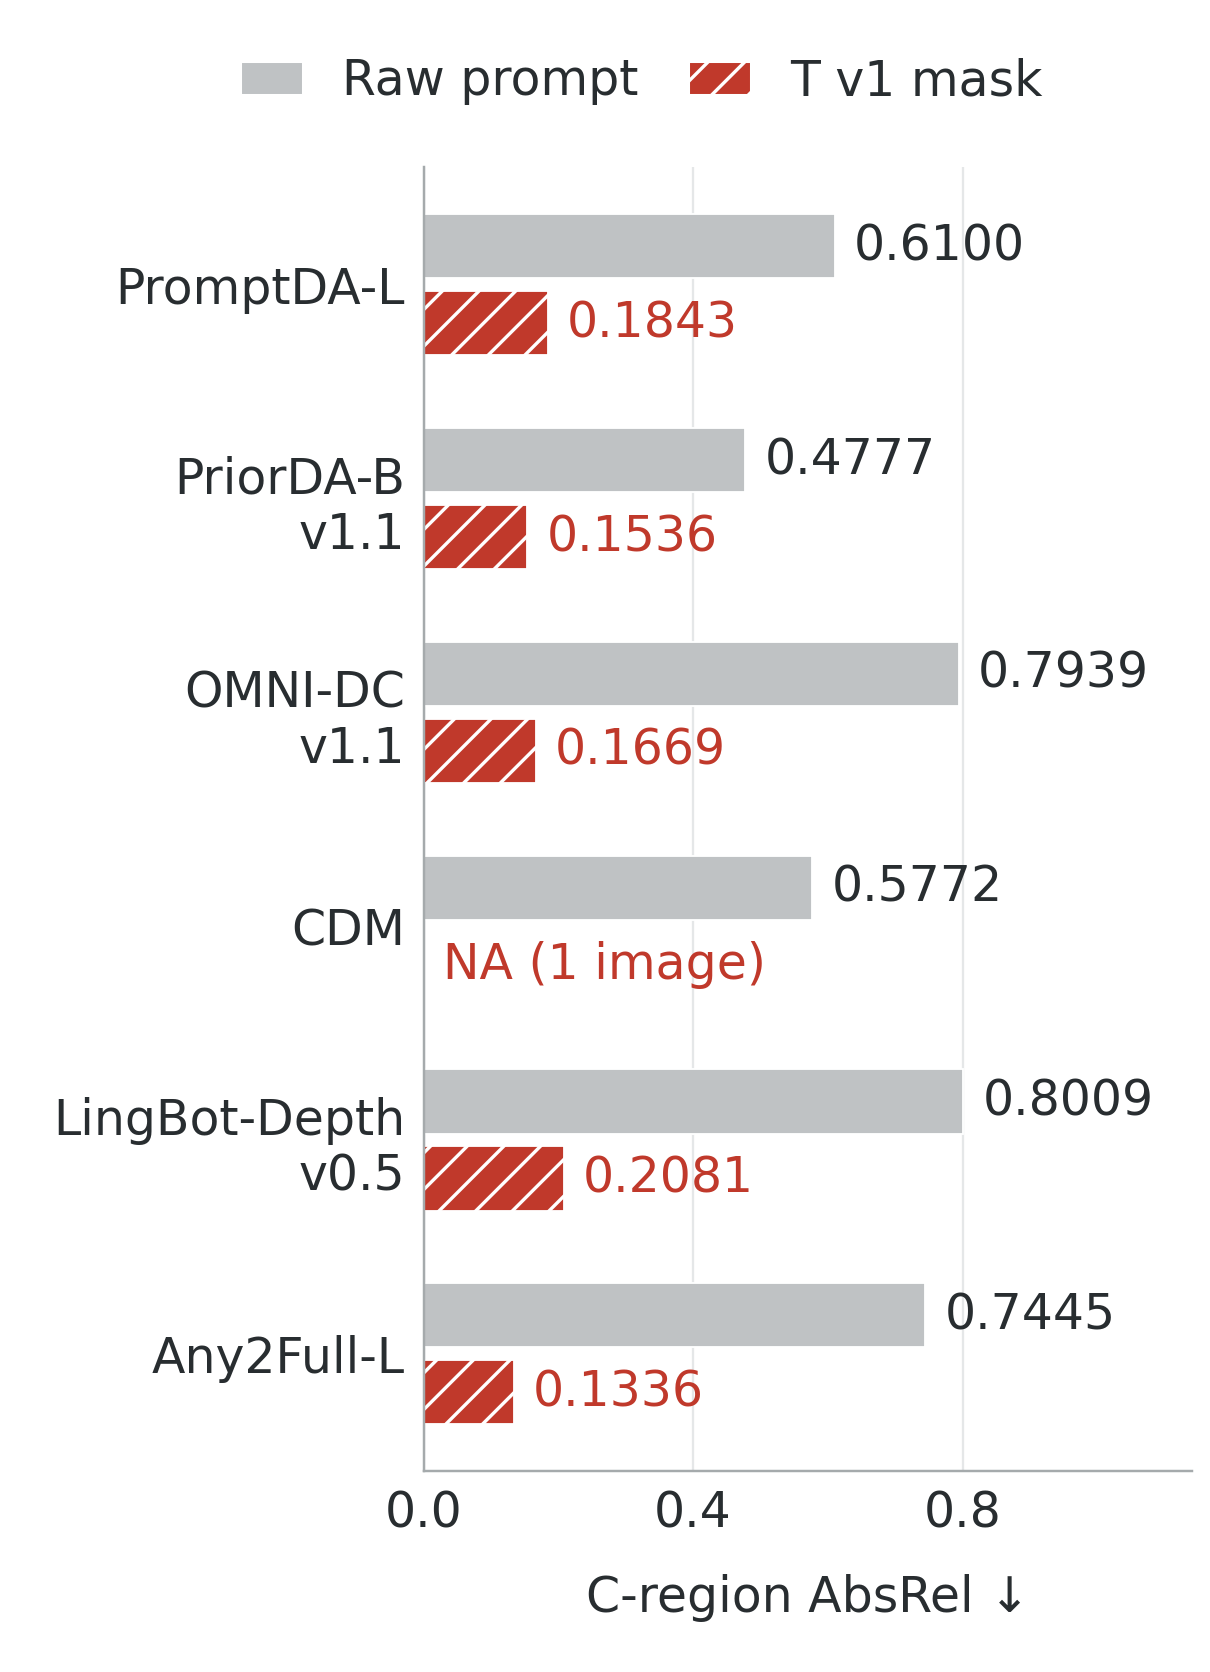
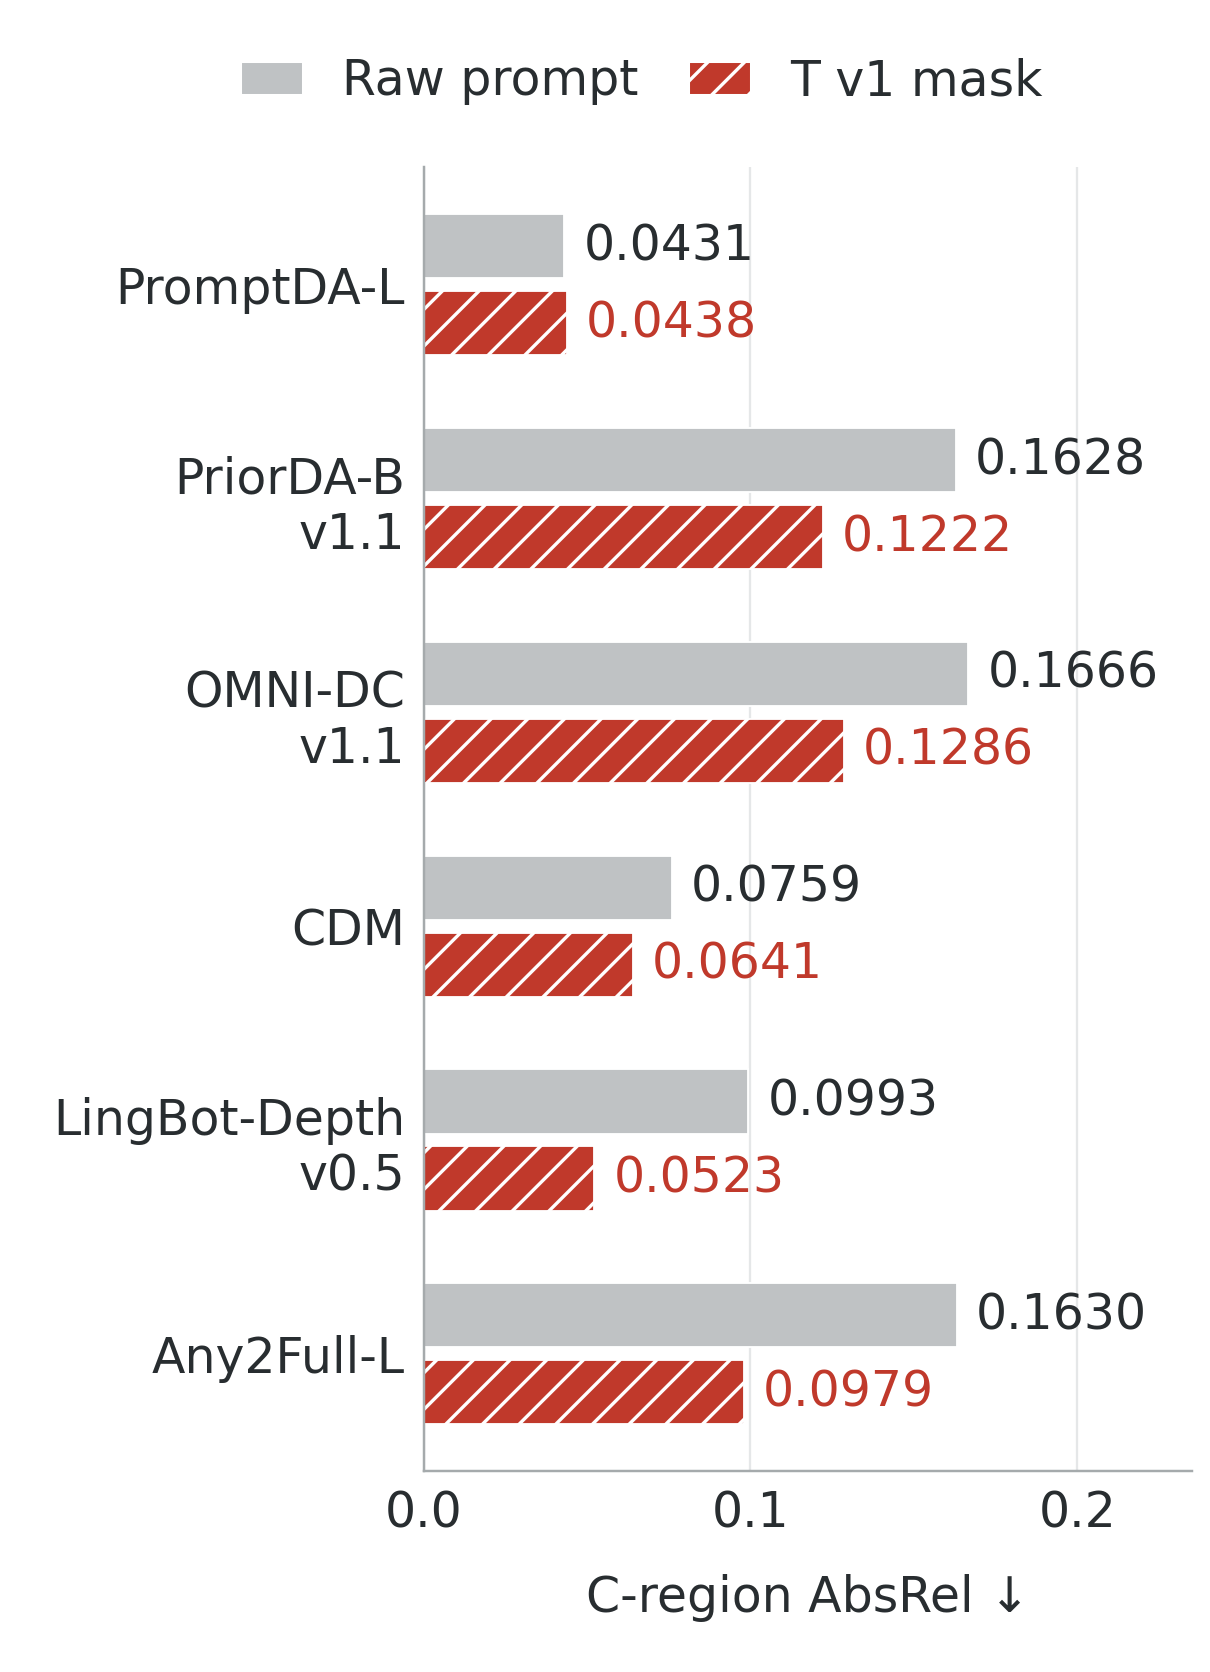
两张图展示点估计,坐标范围不同,完整数值见下表。统计检验使用预注册的配对 bootstrap 与 Holm 校正(α = 0.05);10 项显著比较的校正后 p 均为 0.0012。NA 不表示零误差。查看每项差值与置信区间。
| 模型 | NYU:原始 → T v1 | HAMMER:原始 → T v1 |
|---|---|---|
| PromptDA-L | 0.6100 → 0.1843 | 0.0431 → 0.0438 · 不显著 |
| PriorDA-B v1.1 | 0.4777 → 0.1536 | 0.1628 → 0.1222 |
| OMNI-DC v1.1 | 0.7939 → 0.1669 | 0.1666 → 0.1286 |
| CDM | 0.5772 → NA | 0.0759 → 0.0641 |
| LingBot-Depth v0.5 | 0.8009 → 0.2081 | 0.0993 → 0.0523 |
| Any2Full-L | 0.7445 → 0.1336 | 0.1630 → 0.0979 |
NYU 按场景做 bootstrap;HAMMER 只有 3 个测试场景,按预注册使用长度为 8 的循环帧块 bootstrap。因此 HAMMER 的统计推断仅覆盖这三个场景中的帧,不能直接推广到其他场景。
两个例外,以及干净读数的代价
- CDM / NYU:接 T v1 后,一张图出现无效预测;按固定分母协议,整个比较记为 NA,并以 p = 1 保留在检验族内。
- PromptDA-L / HAMMER:误差差值为 +0.0007,95% CI 为 [−0.0022, 0.0046],没有改善。模型原本对错误提示的继承较轻,可改善空间有限。
- PromptDA-L 的干净区:NYU 从 0.0288 升至 0.0801(+178%),HAMMER 从 0.0130 升至 0.0197(+51%)。误删正确读数会带来实际代价。
其余五个模型没有达到预设的“明显变差”标准(差值 CI 下限 > 0,且均值增加 > 20%);这不等于它们在每个数据集上的干净区均值都没有上升。
风险控制:在 NYU 达标,在 HAMMER 新场景失效
| 数据集 | 冻结阈值 λ | 平均漏检损失 | 目标 ≤ 0.1 |
|---|---|---|---|
| NYU Mirror3D test | 0.72 | 0.027 | 经验风险达标 |
| HAMMER test | 0.46 | 0.129 | 未达标 |
这里的损失是在主评测范围内,每张图的远侧污染像素中未被标记的比例;远侧污染定义为 P > 1.20 × GT,在 192 × 256 网格上统计。没有远侧污染的图像损失记为 0,再对全部图像等权平均。NYU 的 30 张图中有 24 张含远侧污染,0.027 是全部 30 张图的均值。这个定义与主指标的 5% 污染阈值不同。HAMMER 阈值只在单个开发场景标定,新场景上的经验风险超出目标。查看风险检查报告。
CAPA:限制适配监督,可阻挡大部分错误继承
这是次要、描述性的正式 test 实验。NYU 使用 30 张图,HAMMER 每个场景、每种传感器取一帧,共 9 张图。这里的“冻结先验”专指 CAPA 的 UniDepthV2-L 在适配前、经原始读数对齐后的第 0 步输出,不是 T v1 使用的 UniDepthV2-S / Dg。
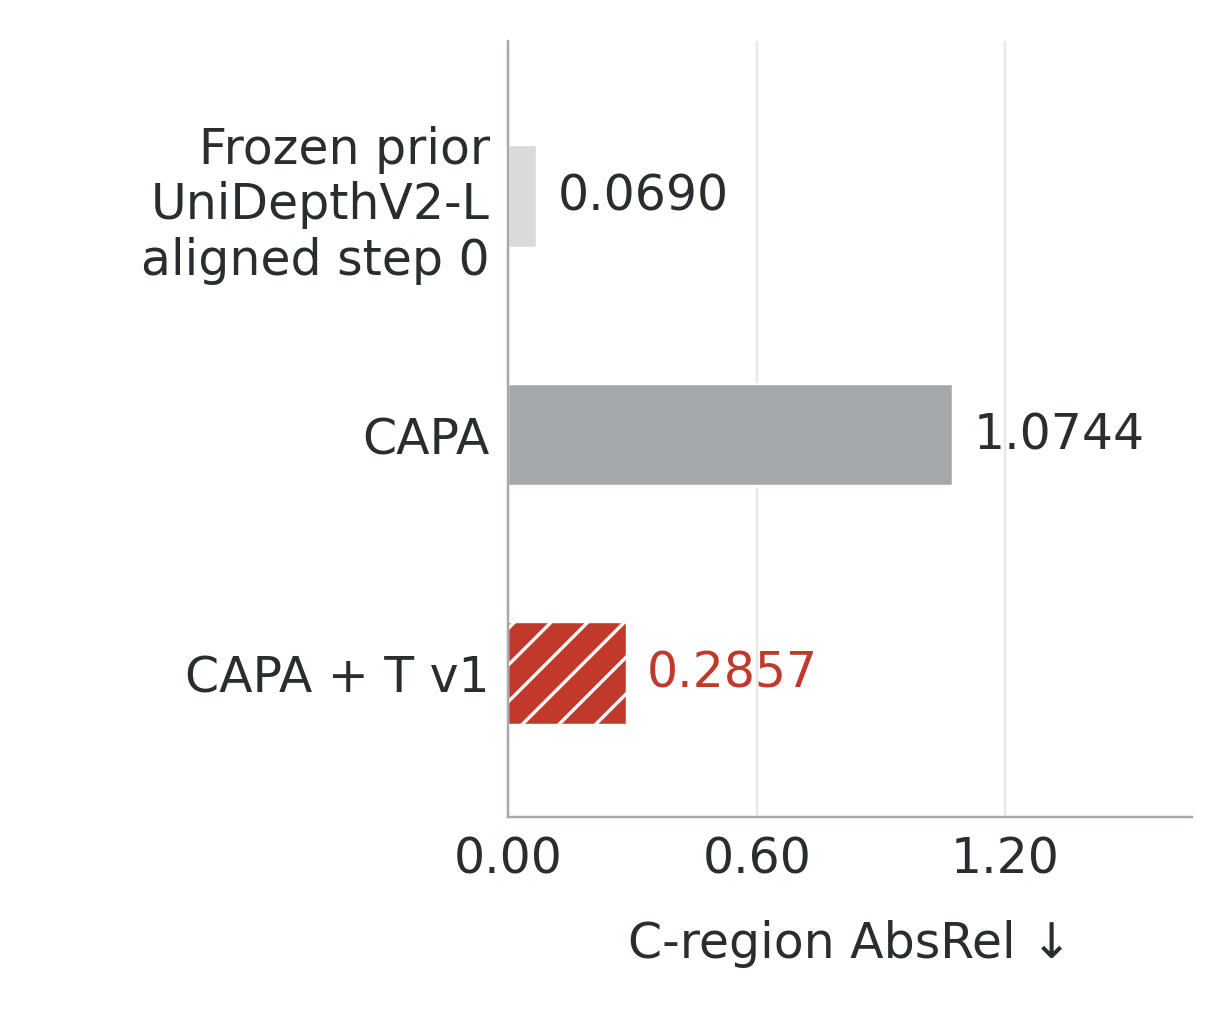
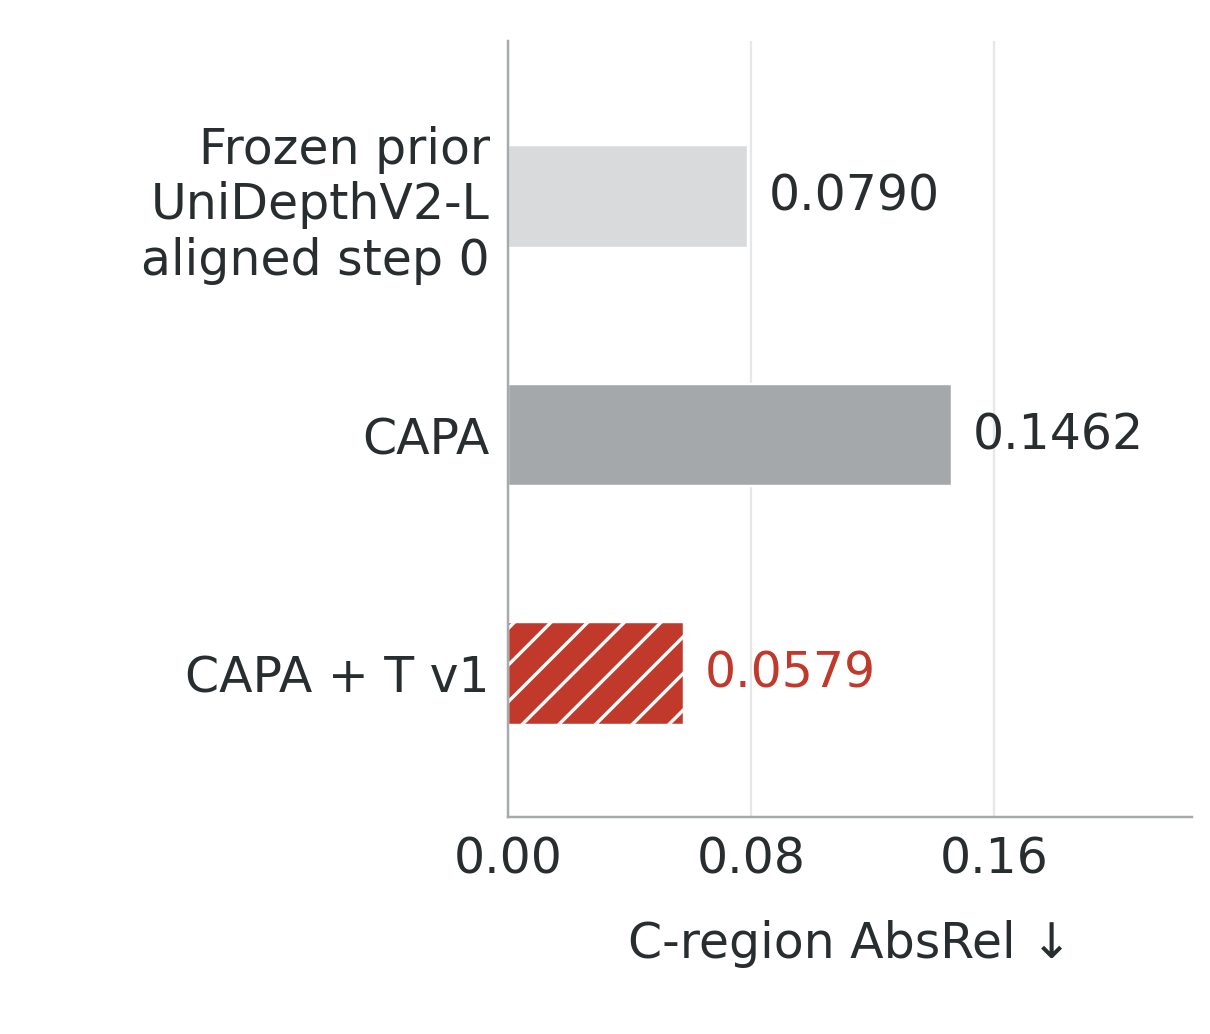
| 配置 · C 区 AbsRel | NYU | HAMMER |
|---|---|---|
| CAPA 冻结先验(UniDepthV2-L,对齐后) | 0.0690 | 0.0790 |
| CAPA | 1.0744 | 0.1462 |
| CAPA + T v1 | 0.2857 | 0.0579 |
| 相对 CAPA 的降幅 | 73.4% | 60.4% |
| 降幅 95% CI | 52.2–95.8% | 46.4–64.6% |
置信区间来自场景 bootstrap,HAMMER 仅有三个场景单元。NYU 的掩码版本仍高于 CAPA 冻结先验的误差,说明漏掉的错误读数仍会进入适配目标。此次 test 的干净区误差变化较小:NYU 为 0.0319 → 0.0349,HAMMER 为 0.0175 → 0.0182。查看 CAPA 正式测试报告。
04 / Conclusion · 把信任作为显式问题
这项研究支持一个实际判断:当传感器会产生结构化错误时,强补全模型或测试时自适应并不会自动解决“该信哪些读数”。外接的先验一致性检查能带来明显收益,但收益依赖模型与场景,必须与误删代价、无效预测和风险控制失效一起评估。
“局部自洽”提供了一种解释:镜面中的 RGB 与深度可能同时描述虚像,两者在局部并不矛盾,全局几何知识才可能揭示错误。这是对多组结果的解释,而非已经证明的普遍机制;相关探索主要来自开发集,直接的局部拟合检验也未通过预注册规则。
适用边界与后续方向
- NYU 的配准深度尚未认证为严格的 RGB 相机轴向 Z;镜面真值来自平面拟合,且采用自定义场景划分。
- NYU test 只有 30 张图,HAMMER 只有 3 个场景;CAPA 仅测试一个适配配置,HAMMER 对比只有 9 张图。
- 未来需要将“信任判断”与“深度纠正”分开建模,并用更多场景验证风险控制。
- 方法 v1 与本次 test 已完成。新的方法选择应使用开发集,并准备新的测试数据。
代码、结果与复现依据
- GitHub 仓库与使用说明:源码、环境要求、实验入口和文档索引。
- 完整分析报告:现象、探索、机制解释与适用边界。
- 正式结果明细与配对比较及置信区间:包括 IR、干净区代价和无效输出。
- 方法冻结协议与SHA256 清单:固定的方法组件与测试前约束。
证据链接固定到本页采用的仓库版本。图表按现有记录重绘;此次内容修订没有重新运行科研评测或调整方法。正式主比较、描述性补充与开发集探索已分别标注。